NASEBANALでは、コンサルティングサービスの中でのトレーニングに活用することを想定して NASEBANAL Quickstarts を開発し、OSSとして公開しています。本ブログでは、テスト実行・Kong経由でのモック切り替え・Kafka非同期化の効果測定という3つのサンプルシナリオを通じて、その概要をご紹介します。
NASEBANAL Quickstartsの開発の背景
AIコーディングエージェントが急速に普及し、要件を伝えて実装そのものを任せる場面が増えてきました。ただ、大きすぎる要件を一度に渡すと、AIも人間と同様に迷いや取りこぼしが生じやすくなります。要件を小分けにして、境界を明確にしたまま管理しやすくするという観点からも、マイクロサービスのようなアーキテクチャが改めて期待されているように感じます。
一方で、サービスの数が増えるほど、その品質管理は重要度を増します。NASEBANALでは、Vitest・Pytest等による単体テスト、Playwright等によるE2Eテストに加えて、SpecmaticやMicrocks等をもちいてシフトレフトを実現する契約テスト、そしてLocust等による負荷テストと、大きく4つのテストツール群を組み合わせた品質保証を提案しています。さらに、APIゲートウェイ(Kong)やイベントストリーミング(Kafka)のような、マイクロサービス特有の構成要素も、実際に手元で試せるようにしています。
ソフトウェアの品質管理・アーキテクチャの方針は、ベンダーごとに、さらにはプロジェクトごとにまちまちで、属人化しているケースが多いように感じています。だからこそ、テスト方針・利用ツール・テスト結果の管理をこうして標準化していくことが、最終的にソフトウェアの品質管理全体の底上げにつながると考えています。
ただ、モノリスの開発では意識する必要のなかった概念が、マイクロサービスアーキテクチャを実装するとさまざまに登場します。イベントストリーミング(Kafka)、APIゲートウェイ(Kong)、サービスディスカバリ(Consul)、契約テスト(Specmatic)やAPIモック(Microcks)などがその代表例で、それぞれに対応する適切なツールを導入すること自体は重要です。ただ、ツールが増えるほど、インストール方法も起動・停止の手順も管理画面へのアクセス方法もツールごとにバラバラで、いちいち覚えていられません。この「ツールごとのやり方の違い」を吸収するために作ったのが、NASEBANALがOSSとして公開しているツール NASEBANAL Quickstarts(リポジトリ名はnb-quickstarts)です。
NASEBANAL Quickstartsの構成と特徴
どのモジュールもmake <module>:up / make <module>:downというDocker Composeの呼び出しに統一されていて、管理画面を持つツールはmake <module>:openでそのままブラウザが開きます。まずはNASEBANAL Stackを構成する技術要素に焦点をあてて、1モジュールずつ切り出している点が特徴です。
サンプルのテスト対象アプリ(appsモジュール)も同梱しているので、PlaywrightやLocustのようなテストツールも、すぐに手元のappsに対して試せます。使い終わったらmake <module>:downで片付くので、ゴミを残す心配もありません。
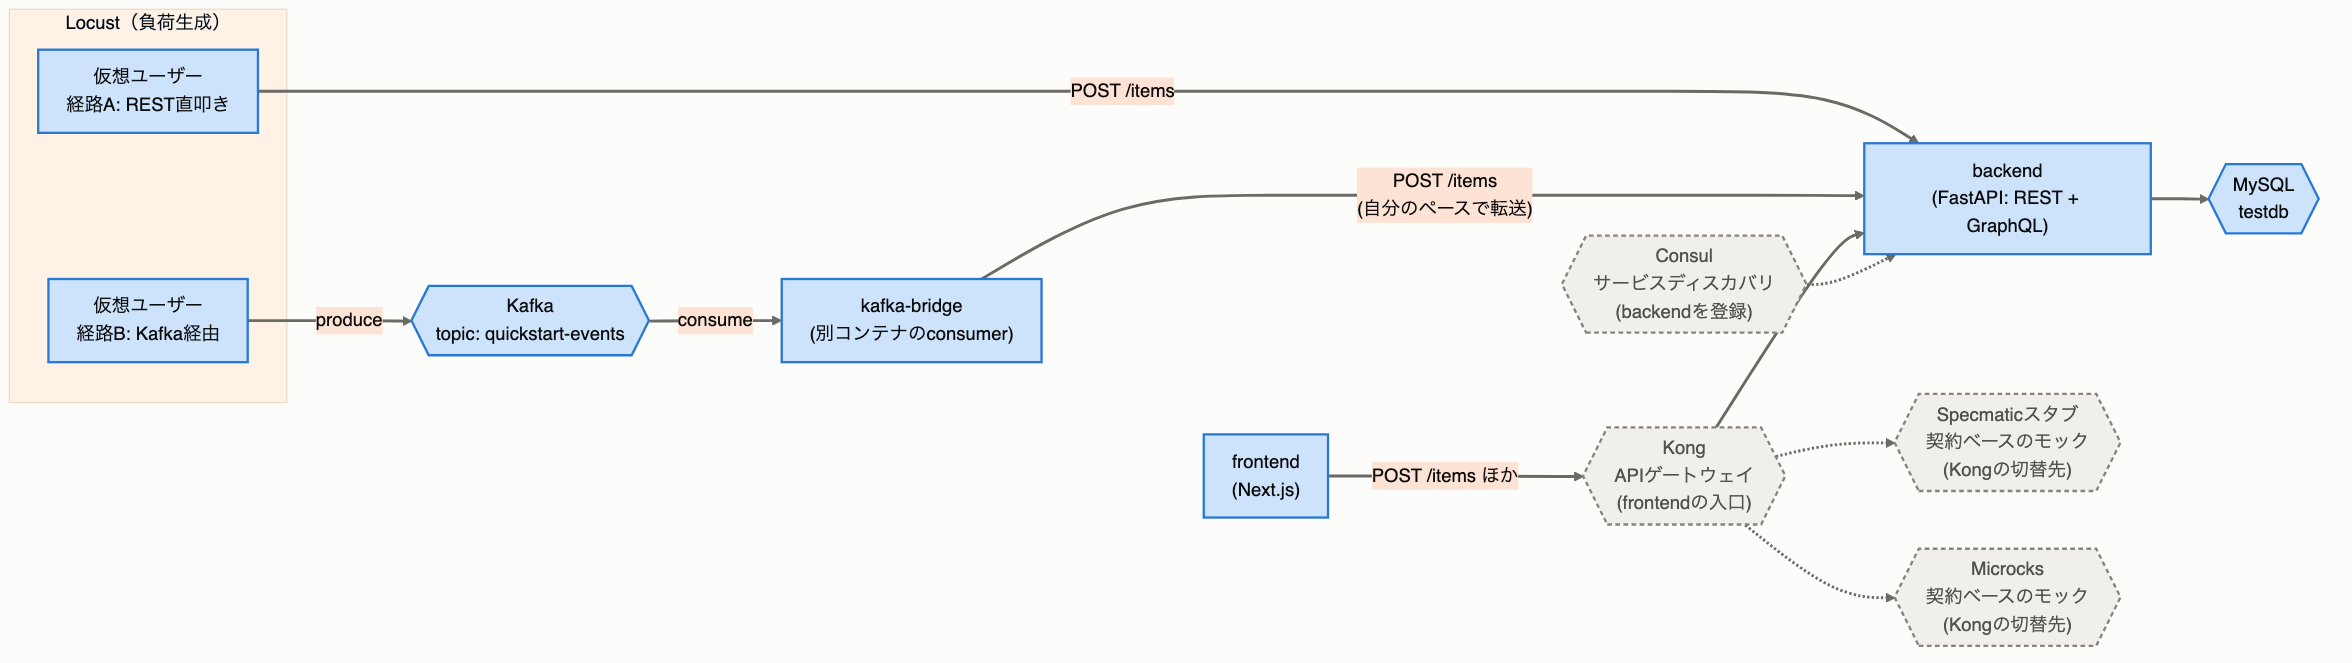
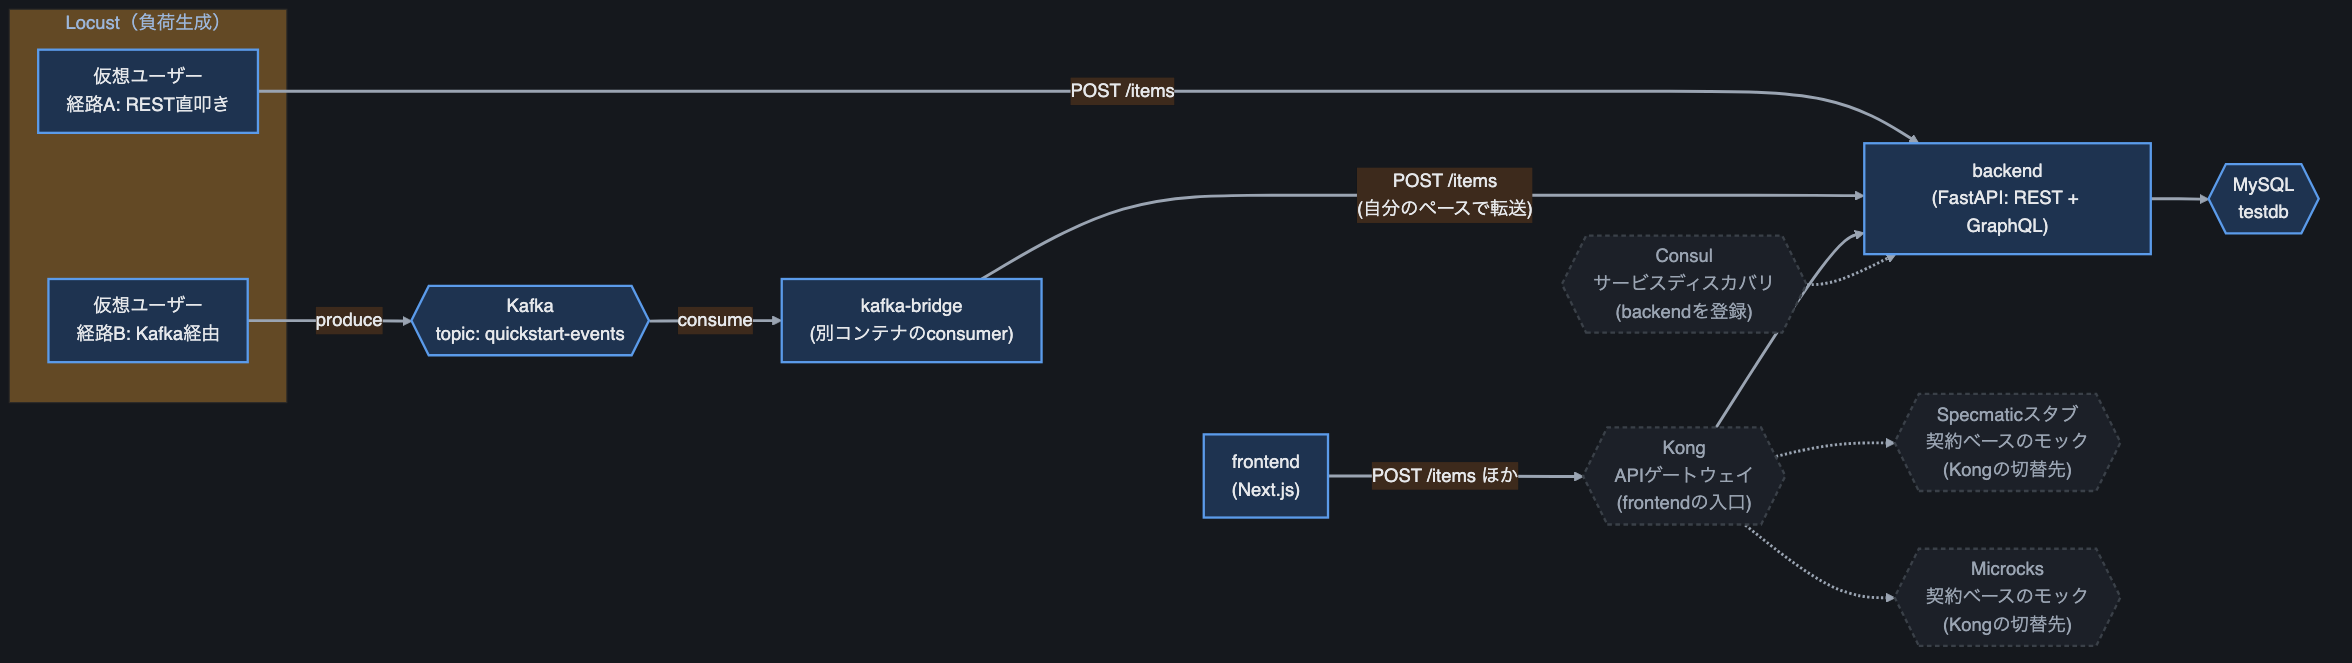
全体像を図にすると、次のようになります。appsモジュール(frontend・backend・MySQL)を中心に、APIゲートウェイのKong、イベントストリーミングのKafkaと非同期→同期の変換を担うkafka-bridge、契約テストのSpecmaticとAPIモックのMicrocksが同じネットワーク上に並び、自由に組み合わせられます。これから紹介する3つのシナリオは、このうちテストツール群・Kong+モック・Kafka+Bridgeをそれぞれ使っています。
テスト用サンプルアプリ
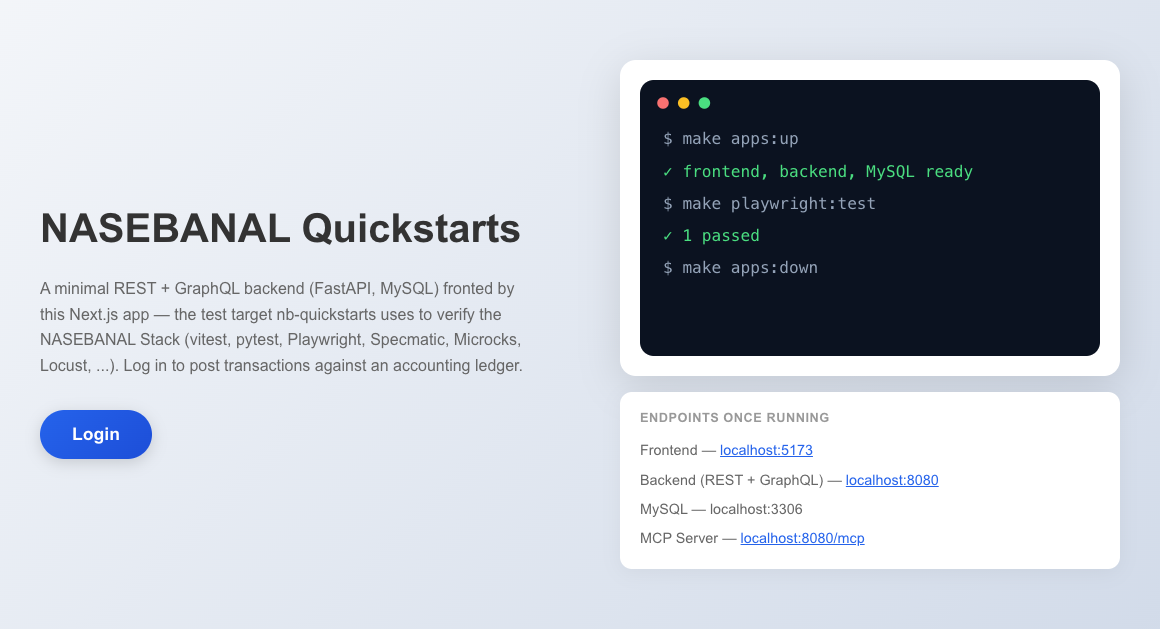
appsモジュールのトップページはこの通りです。ログインもモーダル1つで完結する、シンプルな会計台帳アプリになっています。
ログインすると、勘定科目ごとの残高一覧と、新しい取引を記録するフォームが表示されます。accountsテーブルは、nameが勘定科目(例: "Cash")、1行が1トランザクション(quantityが符号付きの増減額)という、簡易な会計台帳・イベントソーシングの構成になっていて、画面の残高は自分自身のエントリの合計値をそのまま表示しているだけです。
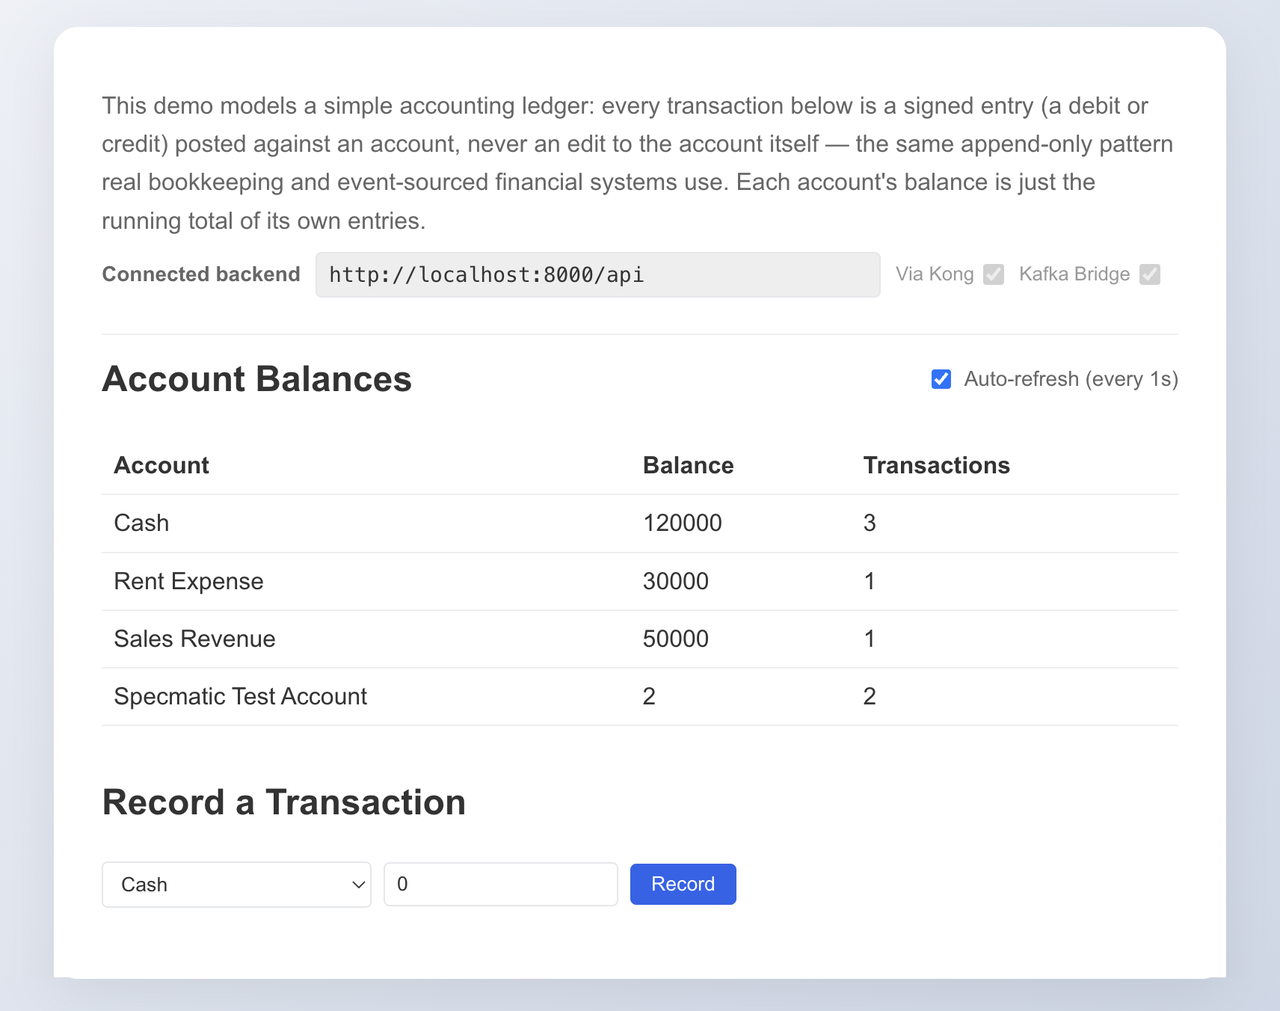
このbackendへの書き込み(POST /accounts)が、これから3つのシナリオを通じて何度も登場する検証対象そのものです。
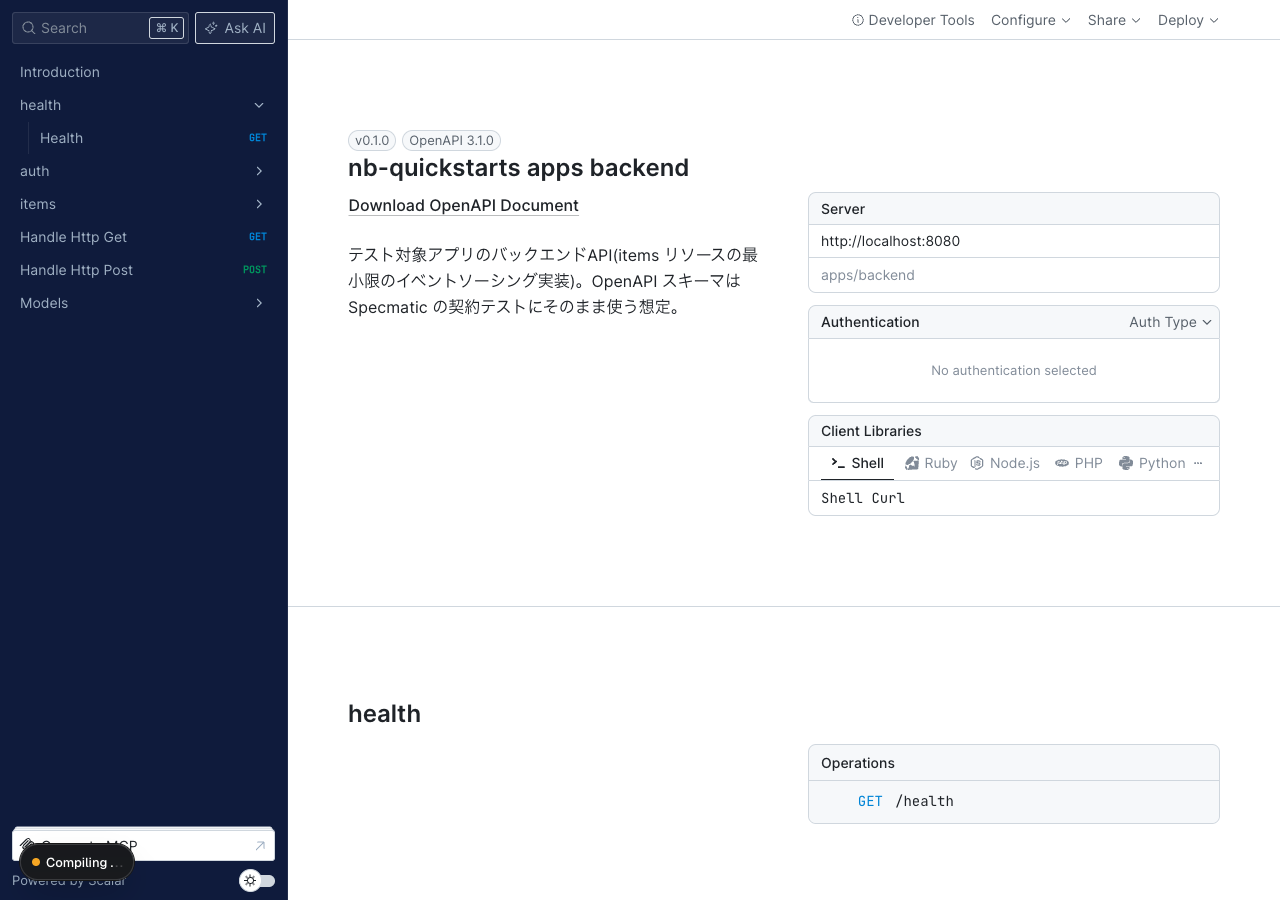
apps/backend自体はOpenAPIのスキーマファイルをリポジトリに手書きで持っていて(apps/backend/openapi.yaml)、起動中のbackendから/openapi.jsonとして動的に配信されます。Contract Driven Developmentは、最初にAPIの呼び出し元のConsumerと、提供側のProviderとの間で認識合わせのための契約、ここではOpenAPIを定義し、それに基づいて、それぞれが開発を進めながら、SpecmaticやMicrocksといったツールを用いて、Mockを立ち上げてはテストを行うというアプローチとなります。SpecmaticやMicrocksはこのスキーマを起動中のbackendから直接取得して契約テスト・モックの元ネタにしていますし、frontendの/api-specsページでも同じスキーマをScalarでそのまま表示しています。
今回は、このNASEBANAL Quickstartsを使って、次の3つのサンプルシナリオを実際に動かしてみました。
- テスト実行 — 単体テスト・契約テスト・E2Eテスト・負荷テストをそれぞれ実行し、出力されるレポートを確認する
- Kong経由での連携 — フロントエンドの接続先をKong経由に切り替えたうえで、Specmatic・Microcksによるモックへ接続先を差し替えて動作確認する
- 非同期連携の効果測定 — Kafka+Bridgeによる非同期連携を導入したうえで、同じ書き込みリクエストをRESTで直接叩いた場合とKafka経由にした場合とで、Locustの負荷試験結果がどう変わるかを比較する
サンプルシナリオ1: テスト実行 — 単体・契約・E2E・負荷テストとレポート
まずは4種類のテストを実際に動かしてみます。どれも「コンテナを立ち上げっぱなしにせずmake <module>:test一発で走らせて確認できる」という同じ操作感で試せるのが、NASEBANAL Quickstartsのポイントです。
make apps:up                # 先にテスト対象appsを起動

make pytest:test            # backendの単体テスト(インメモリSQLite、apps:up不要)
make vitest:test            # frontendの単体テスト(fetchはモック、apps:up不要)
make playwright:test        # 稼働中のfrontendに対するE2Eテスト(apps:up必須)
make specmatic:test         # Provider契約テスト:backendはopenapi.yamlを守れているか(apps:up必須)

make specmatic:stub-up      # 同じ契約から作られたモックサーバー(apps:up必須)
make vitest:contract-test # Consumer契約テスト:frontendのAPI利用はそのモックに対して成立するかそれぞれの実行結果は、次の通りHTMLレポートとして手元に残ります。すべて.gitignoreされており、実行のたびに新しく生成されるものです。
| モジュール | レポートの場所 |
|---|---|
pytest | pytest/report/report.html(pytest-html、単一ファイルに自己完結) |
vitest | vitest/report/index.html(Vitest組み込みのhtmlレポーター) |
vitest:contract-test | vitest/report-contract/index.html(同じレポーターだが出力先は別ディレクトリ) |
playwright | playwright/report/index.html(Playwright組み込みのhtmlレポーター) |
specmatic | specmatic/report/html/index.html、加えてspecmatic/junit/TEST-junit-jupiter.xml(JUnit形式) |
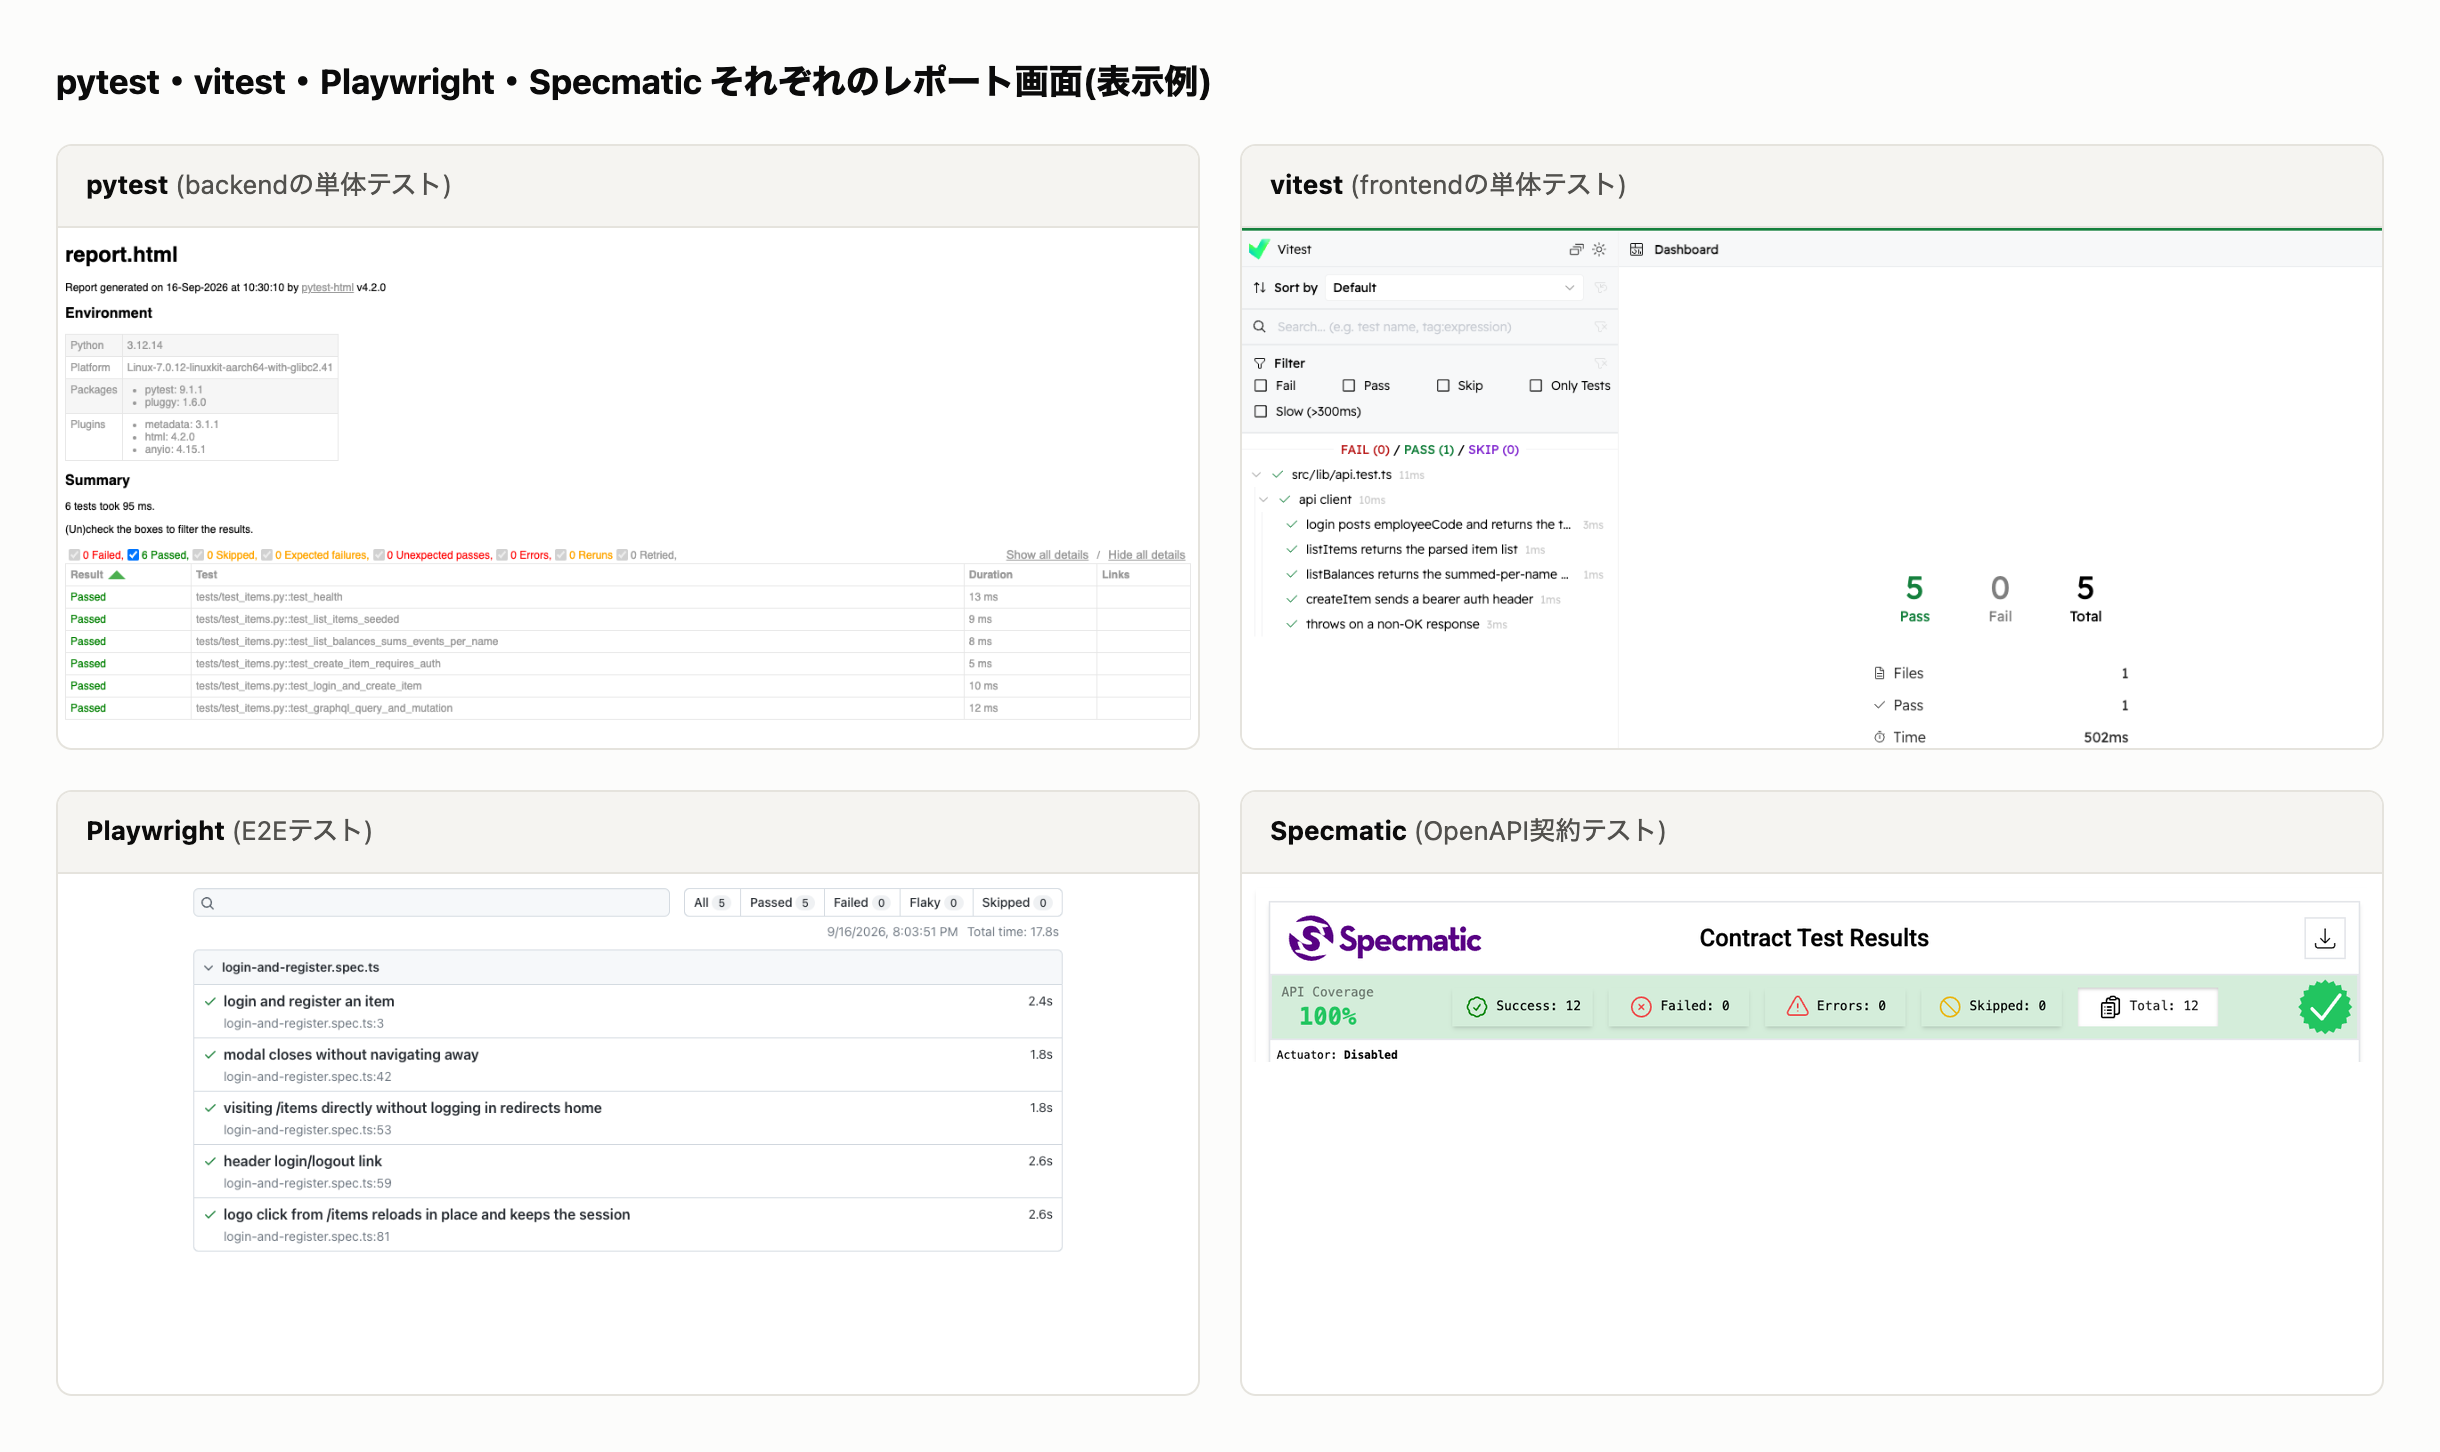
Specmaticの契約テストは、両方向から確認できるようになっている点も特徴です。specmatic:testは稼働中の実backendに対して「本当にこの契約を守れているか」を確認するProvider側のテストで、specmatic:stub-up+vitest:contract-testは、同じ契約から作られたモックに対してfrontendの実際のapi.tsのコードを叩く、Consumer側のテストです。どちらも同じopenapi.yamlを起点にしているので、契約がずれれば両方に検出のチャンスがあります。
負荷テストのLocustだけは少し性質が異なり、1回の実行が単一のHTMLではなく、タイムスタンプ付きのディレクトリ(locust/logs/YYYYMMDD_HHMMSS/)ごと残ります。
target_host.txt— テスト条件(対象ホスト、locustfile、タグ、worker数)result.log/master.log— 実行ログlocust_stats.csv/locust_stats_history.csv— 集計統計・時系列データlocust_failures.csv/locust_exceptions.csv— 失敗・例外の記録report.html— 最終レポート
実行時のパラメータ(対象・実行時間・タグなど)ごと残るので、後から見返して「このレポートはどの条件で走らせたものか」に迷うことがありません。この負荷テストの中身は、シナリオ3で改めて詳しく扱います。
サンプルシナリオ2: Kong経由での連携 — Specmatic・Microcksのモックへの切り替え
次に、frontendの接続先をAPIゲートウェイのKong経由に切り替えたうえで、その先を実backendではなくモックへ差し替えてみます。
make kong:up
# .env: NEXT_PUBLIC_API_BASE=http://localhost:8000/api
make apps:restart # frontendの再作成が必要 — Next.jsのdevモードはNEXT_PUBLIC_*をサーバー起動時にバンドルへ焼き込むためkong/conf/declarative.ymlのapps_backendというサービス定義が、http://localhost:8000/api/*へのアクセスをbackend自身のルート(strip_path: trueなので/api/accountsはbackend:8080/accountsに届く)へプロキシしています。このapps_backendの接続先こそが差し替えの一点突破口で、実backendの代わりに同じ契約から作られたモックを指すよう向き先を変えるだけで、frontend側もテスト側も一切コードを変える必要がありません。
| 接続先 | ホスト(コンテナネットワーク内) | ポート | パスプレフィックス |
|---|---|---|---|
| 実backend | backend | 8080 | (なし) |
| Specmaticのスタブ | specmatic-stub | 9091 | (なし) |
| Microcks | microcks | 8080 | /rest/nb-quickstarts+apps+backend/0.1.0 |
Specmaticのスタブへ切り替える — vitest:contract-testが使っているものと同じモックを、今度はKong経由で叩きます。
make apps:up
make specmatic:stub-up
# kong/conf/declarative.yml: apps_backendのurlをhttp://specmatic-stub:9091に変更
make kong:reset
curl http://localhost:8000/api/accounts/1   # -> 実backendではなくSpecmaticのスタブが応答
Microcksへ切り替える — こちらはopenapi.yamlに埋め込まれたサンプル値(GET /health、GET /accounts、GET /accounts/balances、GET /accounts/{account_id}、POST /auth/login)をそのまま返すモックです。POST /accountsはBearerトークンが必要で、OpenAPIのサンプルにはヘッダーを表現する手段がないため対象外としています。MicrocksのモックURLは/rest/<サービス名>/<バージョン>/<パス>という実APIとは異なる形をしているので、apps_backendの接続先にはこのプレフィックスごと含めておき、Kong側は/apiを取り除いた残りをそのまま付け足す形にします。
make apps:up
make microcks:up
make microcks:import-openapi
# kong/conf/declarative.yml: apps_backendのurlをhttp://microcks:8080/rest/nb-quickstarts+apps+backend/0.1.0に変更
make kong:reset
curl http://localhost:8000/api/accounts/balances # -> 実backendではなくMicrocksのモックが応答どちらの切り替えも、動かして終わりではなく実際に検証しました。Kong経由に切り替えたfrontendに対してplaywright:testを一通り走らせ、そのすべてのリクエストがKong自身のアクセスログに/api/*向けとして記録されること、そしてそれぞれのモックに向き先を変えた状態でcurlを叩くとopenapi.yamlのサンプル値がそのまま返ってくることを、MicrocksとSpecmatic双方の自前のリクエストログとあわせて確認しています。試したあとはapps_backendのurlをhttp://backend:8080に戻してmake kong:resetすれば、実backend向けに復帰します。
declarative.ymlを直接編集する代わりに、Kong Managerの画面から同じ差し替えをすることもできます。KONG_DB=postgres(make kong:up KONG_DB=postgres、または.envで設定)が条件で、DB-lessモードのAdmin APIは読み取り専用のため、Kong Managerでapps_backendを表示はできても保存はできません。Postgresモードなら、apps_backendという1つのサービスをUIから編集した時点ですぐ反映され、kong:resetも不要です。
make kong:open(または http://localhost:8002 を開く)→ Gateway Services →apps_backend→ Edit- Host(Microcksの場合はPortとPathも)をモック側の値に変更してSave
curl http://localhost:8000/api/accounts/balances(またはKong経由のfrontendをリロード)でモックが応答していることを確認 — Kongの各ワーカープロセスへの反映に数秒かかることがあります- 元に戻すときは、もう一度
apps_backendを編集してHost/Port/Pathを実backendの値に戻してSave
apps_backendというサービス定義は常に1つしか存在しません。実backend・Specmatic・Microcksの3つを別々のサービスとして登録し、使わない2つを無効化して切り替える、というやり方も試しましたが、KongのRouteオブジェクトにはenabledフィールドがなく(Service側にしかありません)、同じパスに複数のRouteが競合している場合、無効化したServiceの背後にあるRouteへは決してフェイルオーバーせず、Kongのルーターは常に同じ1つの勝者を固定的に選び続けてしまいます。そのため、1つのサービス定義をその場で書き換える今回の方式が、UIからの切り替えとしては確実です。
どの手段で切り替えたかによらず、一番確実に実backendへ戻す方法はmake kong:resetです。これはKongが現在DBに持っているルート・サービス・プラグインをすべて削除し、kong/conf/declarative.ymlから丸ごと読み直すので、UIやAdmin API経由で何をどう変更していたとしても関係なく、確実に既知の状態へ戻せます。
サンプルシナリオ3: 非同期連携の効果測定 — Kafka+Bridgeの導入とLocustの結果比較
最後に、今回のaccountsテーブルの書き込みをKafka経由の非同期連携に置き換え、それが負荷試験の結果にどう効くかを実測します。
イベントソーシングとの相性
まず前提として、backendのaccountsテーブルが、勘定科目の残高を直接書き換えるのではなく、取引を1件ずつ追記していくイベントソーシングの構成になっている点に触れておきます。要件的にはイベントソーシングの方が適している場面——「最新の状態」そのものより「何が起きたか」という記録に価値がある場面——でも、適切に用いられていない場面を目にします。
イベントソーシングでは、書き込みは常に新しいレコードの追加(INSERT)だけで完結し、既存の行を更新(UPDATE)する必要がありません。同じ行を複数のリクエストが取り合ってロックする、という構図がそもそも発生しないため、ロック待ちやデッドロックに起因する不具合のリスクが小さくなります。また、1件1件のイベントはそれぞれ独立して意味を持ち、後から書かれたイベントが先に書かれたイベントの内容を上書きするわけでもないので、書き込みの順序性についても神経質にならずに済みます。
ポイントは、すべての書き込みをINSERTだけで完結させ、残高のような「現在の状態」はその集計で導出する、という方針を一貫して貫く必要がある、ということです。どこかで部分的にでも更新(UPDATE)処理を持ち込んでしまうと、そこだけロックや順序性の問題が舞い戻ってきて、イベントソーシングの良さが実現されなくなっていきます。
この「単純な追記だけで完結し、順序も気にしなくていい」という性質は、Kafkaのような非同期メッセージングの仕組みと相性がよく、実装をシンプルに保ったまま非同期化しやすくなります。結果として、backendの瞬間的な処理能力に呼び出し側の成否が引きずられにくくなり、可用性の向上にも寄与します。
Kafka+Bridgeの導入
make apps:up
make kafka:up
make kafka:bridge-upkafka:bridge-upは、Kafkaのトピックを読み取って各イベントをPOST /accountsとしてREST backendへ転送する、小さな単独のコンシューマ(kafka/bridge/)を起動します。転送先はデフォルトではapps/backendですが、KAFKA_BRIDGE_TARGET_URLで他のツールと同様に任意のホストへ向けられます。kafka:upとはあえて別コマンドに分けてあり、独立したコンテナとして動くので、Kafkaやbackend側で障害が起きても影響範囲はbridge自身にとどまります。実際、転送に失敗した場合は成功するまで延々とリトライを続け、Kafkaのオフセットは配信に成功した後にしかコミットしないため、障害時は「イベントが失われる」のではなく「取り込みが一時停止する」という挙動になります。backend自身はKafkaの存在をまったく知りません——Kafkaが落ちていても、あるいはkafka-bridgeごと止まっていても、backendには一切影響しない設計です。
RESTによる同期通信とKafka経由の非同期通信のエラー発生の違い
RESTでリクエストを同期的に直接処理する構成は、シンプルで分かりやすい反面、注意しないと痛い目に遭います。想定より多くのリクエストが一時に集中したタイミングでエラーが発生しやすく、しかもそのエラーへのリカバリー(再送、部分失敗の切り分け、利用者への通知など)を呼び出し側がまるごと背負うことになります。こうした「一時的なリクエスト集中でエラーが起きやすく、リカバリーも大変になる」シナリオが懸念されるなら、Kafkaのようなメッセージング基盤を書き込みの前段に挟むことで、呼び出し側の成否をbackendの瞬間的な処理能力から切り離せる、というメリットがあります。
今回は、このメリットを実際に数字で確認するために、NASEBANAL Quickstartsを使って比較テストを行いました。
Locustについて — User数とRPS、そしてスケールアウト
比較の中身に入る前に、今回の負荷生成に使ったLocustの仕組みにも簡単に触れておきます。
Locustでは、負荷の強さを「User数」——同時に動かす仮想ユーザーの数——で指定します。1ユーザーは1つの仮想クライアントとして、設定したtask(今回であればPOST /accountsの送信)を実行し続けます。wait_timeをゼロにすると、リクエストとリクエストの間で待たずに連打し続けます。
その結果として出力されるのがRPS(Requests per second、秒間リクエスト数)です。ここが重要なポイントで、RPSはLocustに直接指定するパラメータではなく、あくまで結果として出てくる値です。User数を増やしても、対象サーバー側の処理が追いつかなければ、RPSはむしろ頭打ち・低下し、レイテンシが伸びたり失敗が増えたりするだけです。
つまりLocustの結果を見るときは、「RPSが伸びない・低い」ときに、原因が次のどちらなのかを見極める必要があります。
- 負荷生成側(Locust)のUser数が足りない — 1プロセスが生成できる同時リクエスト数には上限があるので、単にもっと負荷をかければRPSは伸びる
- 対象サーバー側のスループットが頭打ちになっている — User数を増やしてもRPSが伸びない・失敗率が上がるなら、ボトルネックはサーバー側にある
後述する経路A(REST直叩き)の結果はまさに2の例です。600ユーザーを投入しても、backend側のコネクションプールがボトルネックになり、実際に捌けたリクエストは60秒でたった58件(RPSにするとほぼ1件/秒)でした。ここでさらにUser数を増やしても、RPSは伸びず、失敗率が悪化するだけです。
逆に、Locust自体の負荷生成能力が足りているかを確かめる・増やすには、スケールアウトという手段があります。ローカルではLOCUST_WORKERSでworkerコンテナの数を増やせますし、1台のマシンでも足りない規模の負荷をかけたい場合は、make locust:join-clusterで別マシンをworkerとしてクラスターに参加させることもできます。masterがUserを各workerに割り振り、各workerが対象サーバーにリクエストを送り、応答時間や成功・失敗をmasterに集約する、という構成です。
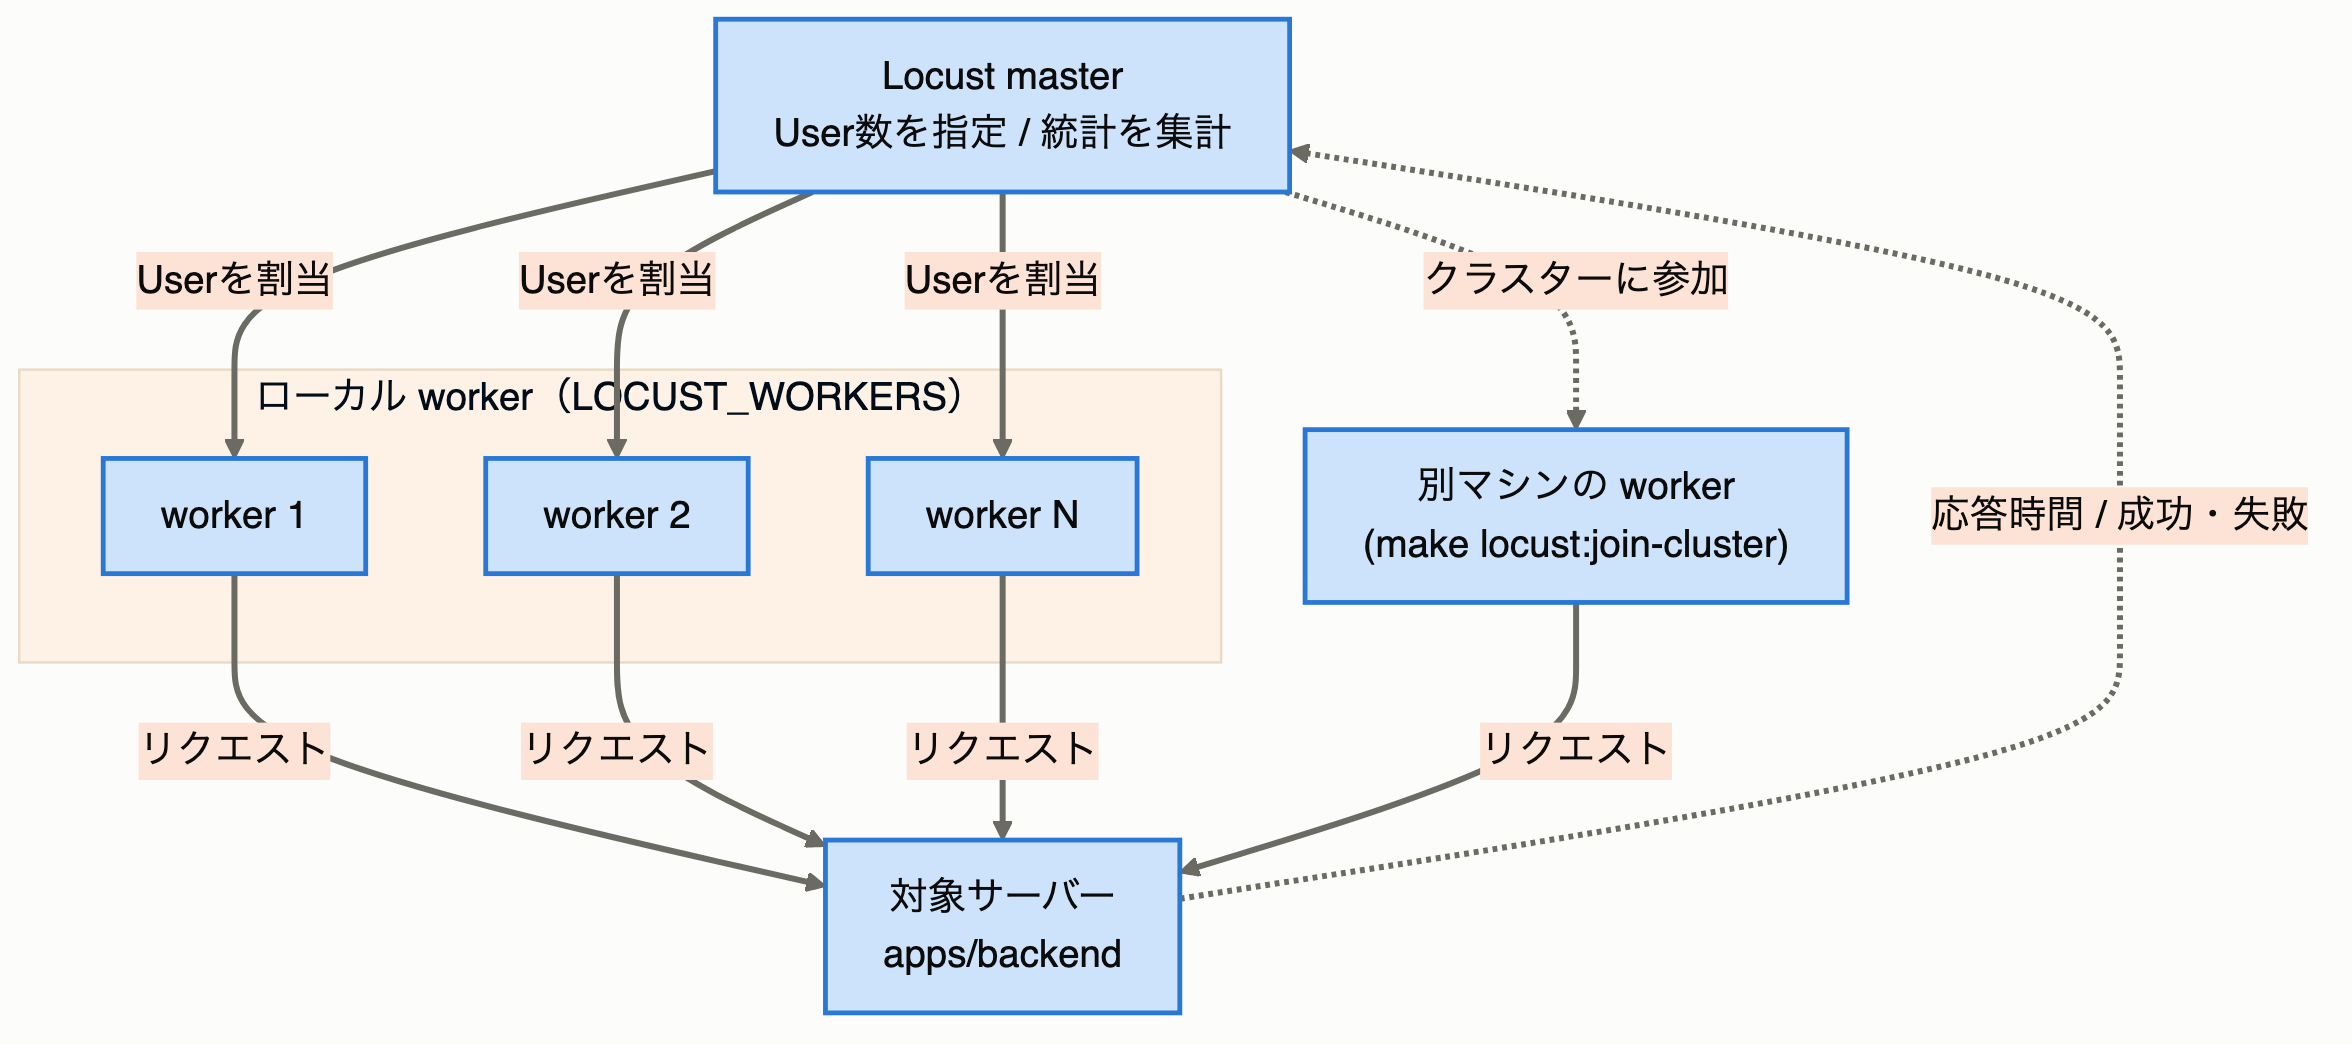
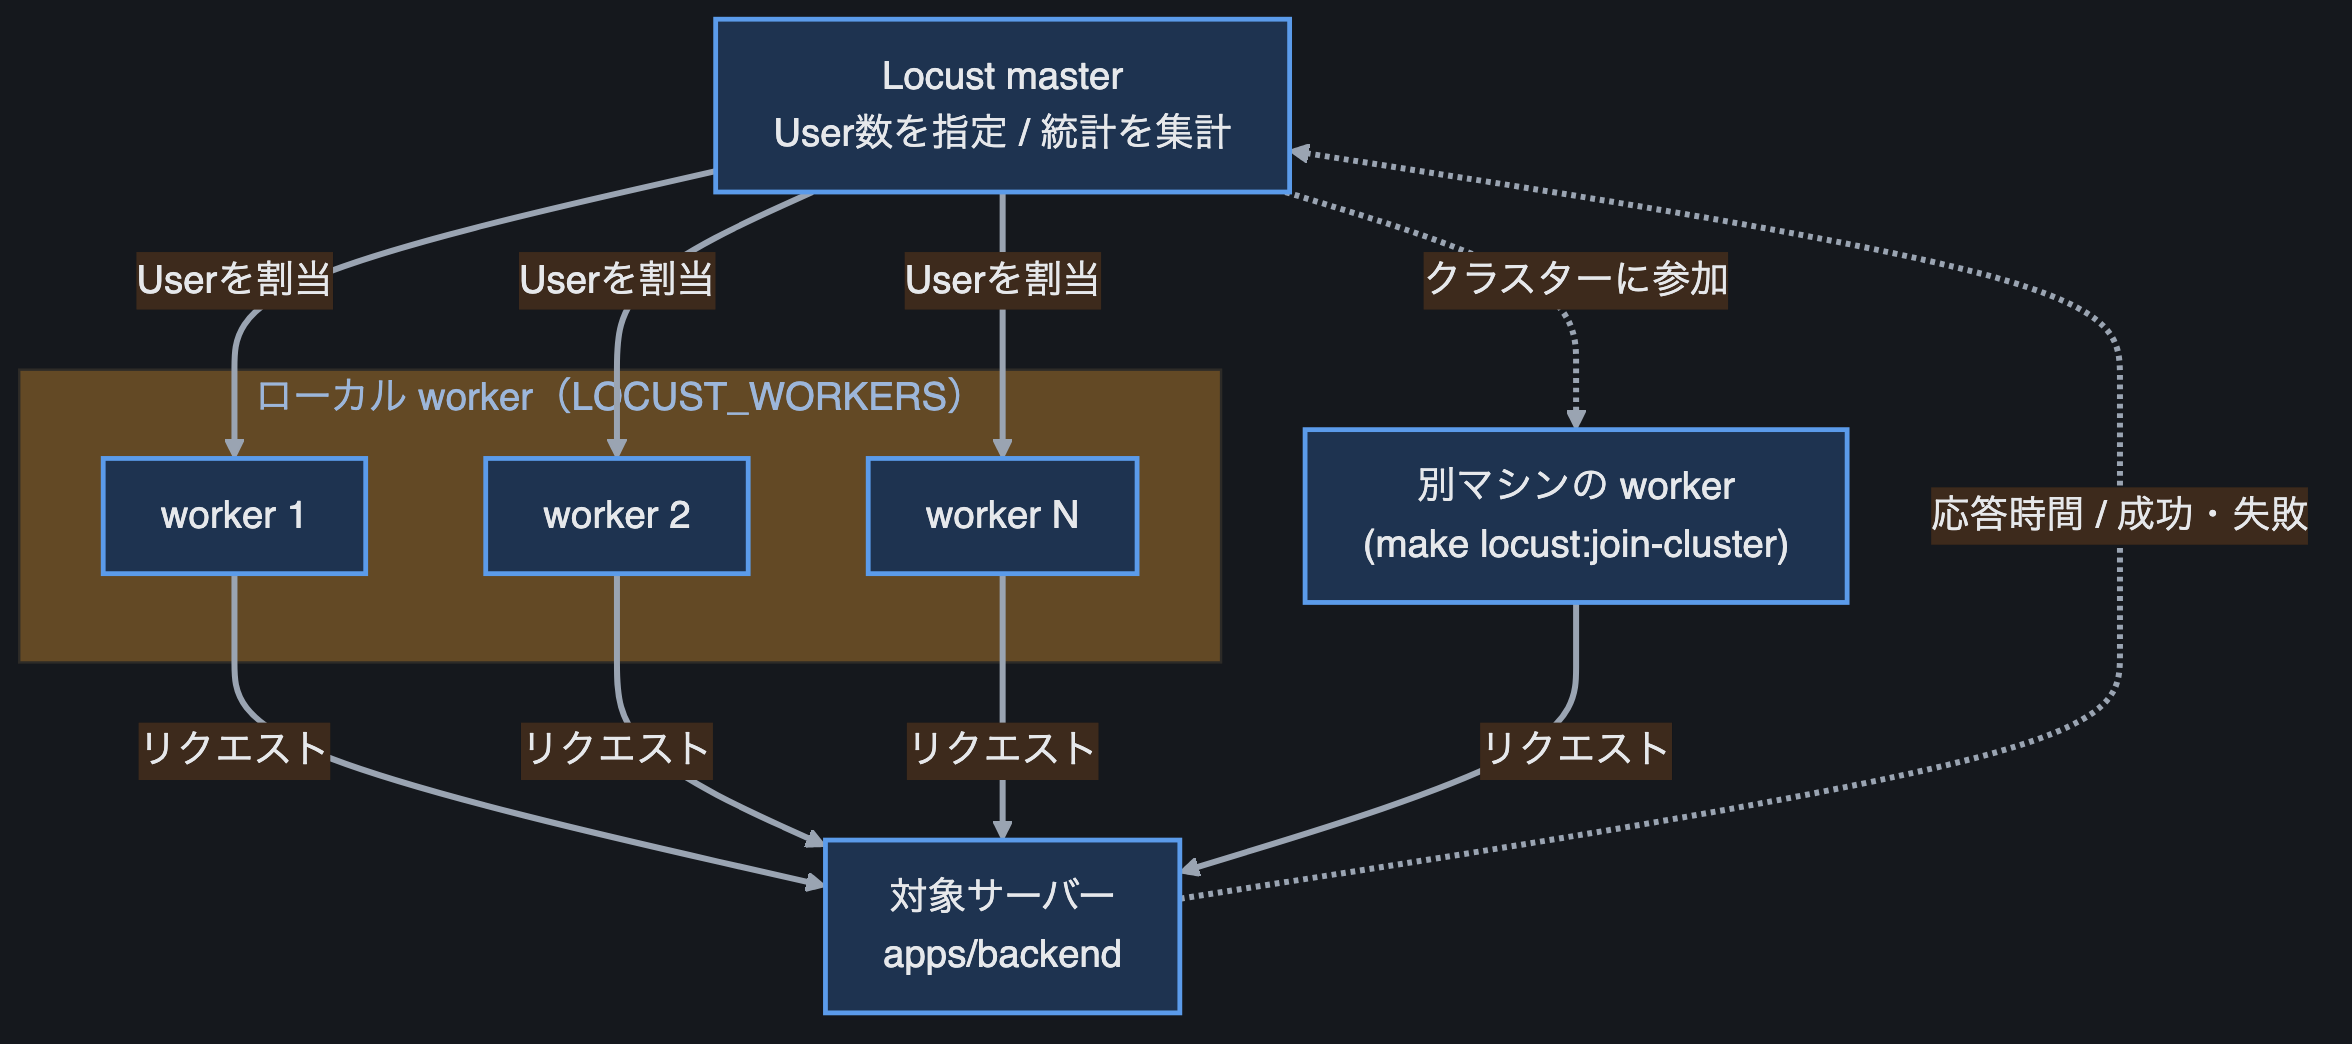
今回の実験自体は、1台のラップトップ・シングルworkerのまま、あえて対象サーバー側を非力な設定にして行っています(サーバー側の限界を見るのが目的だったため)。より高いRPSを狙う負荷試験をしたい場合は、このスケールアウトを検討することになります。そしてNASEBANAL QuickstartsではLocustのクラスター設定も可能になっています。
実験の設計 — 同じ書き込みを2つの経路で流す
比較したのは、apps/backendへの書き込みを継続的に発生させる、次の2つの経路です。
- 経路A(同期・REST直叩き): Locustの仮想ユーザーが、
POST /accountsを直接叩き続けます(locustfile_http_overload.py)。 - 経路B(非同期・Kafka経由): 同じイベントを、いったんKafkaのトピックに流し込むだけです(
locustfile_kafka.py)。backend側では、先ほど起動したkafka-bridgeがトピックを読み取り、自分のペースでPOST /accountsに変換して転送します。
どちらも「think timeゼロ(仮想ユーザーがリクエスト間で待たない)・600ユーザー・spawn rate 200ユーザー/秒」で60秒間、連続的に負荷をかけ続けます。実際のトラフィックというより、瞬間的なバーストを意図的に再現した過負荷シナリオです。backend側は1台のラップトップ上のDockerで、uvicornをシングルワーカー・--reloadモードのまま、SQLAlchemyのコネクションプールもデフォルト(pool_size=5 + max_overflow=10)という、チューニング前提のか弱い構成のまま計測しています。
実行手順
make apps:up
make kafka:up
make kafka:bridge-up

# 経路A: REST直叩き
make locust:test LOCUST_FILE=locustfile_http_overload.py \
  LOCUST_USERS=600 LOCUST_SPAWN_RATE=200 LOCUST_RUN_TIME=60s

# 経路B: Kafka経由(同じ負荷パターン)
make locust:test LOCUST_FILE=locustfile_kafka.py \
  LOCUST_USERS=600 LOCUST_SPAWN_RATE=200 LOCUST_RUN_TIME=60s
同じ環境・同じ負荷パターンで2分と空けずに連続実行しているので、実行タイミングの違いによるブレはほぼありません。
結果
経路A(REST直叩き): 60秒間で送れたPOST /accountsは58件、そのうち46件が失敗しました(失敗率79%)。内訳は「500 Internal Server Error」が38件、「ConnectionResetError(接続リセット)」が7件、「RemoteDisconnected(応答なしで切断)」が1件です。失敗したリクエストの多くはLocustのタイムアウト上限である30秒近くまで応答が返らず、/accountsだけの平均応答時間は23,477ミリ秒(23秒台)まで悪化しました。過負荷で仮想ユーザーが軒並みブロックされ、60秒間でこなせたリクエスト自体がそもそも少なかった、というのが実態です。
経路B(Kafka経由): 同じ60秒間で、124万1,297件のイベントをKafkaに送り込み、失敗は0件(失敗率0%)でした。中央値レイテンシは23ミリ秒、平均24.3ミリ秒、スループットは秒間約20,673件と、REST直叩きとは桁が2つ以上違う速度で受け切っています。backend自身の/healthエンドポイントの応答時間も、その間ずっと約2ミリ秒のまま安定していました。
Locustが1秒ごとに記録した累積リクエスト数をそのままグラフにすると、この差は一目瞭然です(縦軸は対数目盛。REST直叩きは序盤で頭打ちになり、Kafka経由は60秒間ほぼ一定の傾きで伸び続けています)。
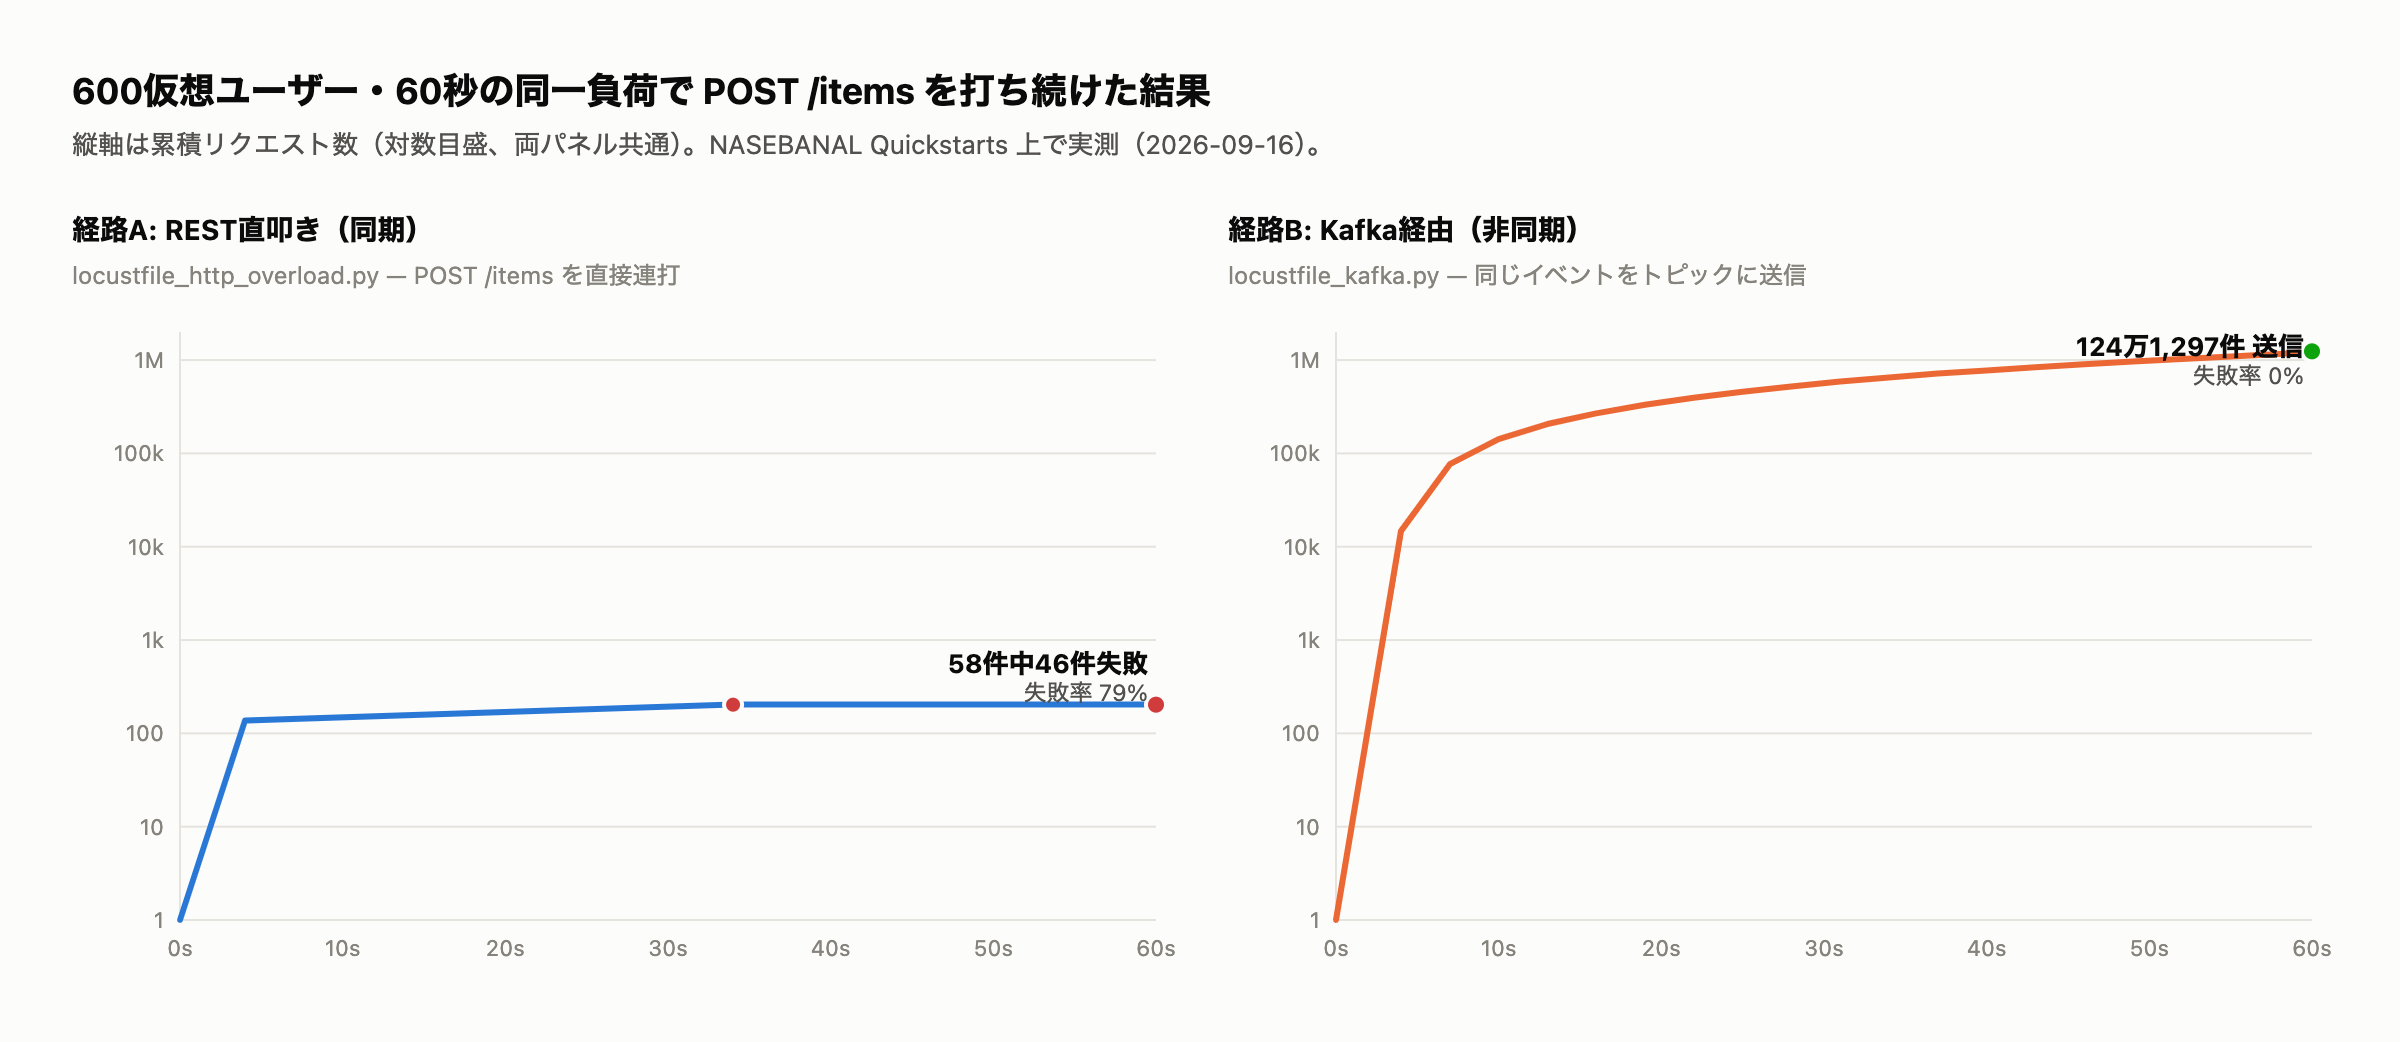
- REST直叩き: 58件中46件失敗(79%失敗)、応答は秒単位まで悪化
- Kafka経由: 124万1,297件中0件失敗(0%失敗)、応答は終始ミリ秒単位で安定
なぜこの差が出るのか
RESTで直接叩く経路では、呼び出し側の成功・失敗が、その瞬間のbackendの処理能力にそのまま連動します。今回のbackendは意図的にシングルワーカー・小さなコネクションプールのままにしているので、600ユーザー分のリクエストが一斉に押し寄せると、プールが枯渇し、接続が詰まり、タイムアウトや500エラーが発生します。呼び出し側は「backendが今どれだけ空いているか」を一切考慮せずに投げ続けるので、負荷がそのままエラー率に変換されてしまいます。
Kafka経由の経路では、呼び出し側(Locustの仮想ユーザー)がやっていることは「Kafkaのログに追記する」だけです。これはbackendの処理能力とは無関係に、ブローカー側の書き込み性能だけで決まります。kafka-bridgeはトピックを自分のペースで読み取り、1件ずつ順番にPOST /accountsへ変換して転送するので、backendから見れば負荷は常に「バーストではなく、一定のペースで流れてくる普通のリクエスト」に均されています。つまりKafkaは負荷そのものをなくしているわけではなく、バーストを吸収して、backendに届く形を変えているというのが実態です。
これは「非同期メッセージングは万能」という話ではありません。Kafkaを挟めば運用コストや構成の複雑さは増えますし、kafka-bridgeがbackendに書き込み切るまでの間はデータが「まだ反映されていない」状態が続く、結果整合性の話も当然出てきます。ただ、書き込みの受け口とその処理能力を分離しておくと、瞬間的な負荷の受け止め方がまるごと変わるということを、実際に数字で確認できたのは収穫でした。
まとめ
今回のブログは、何か特定の実験結果を報告するものというより、NASEBANAL Quickstarts そのものの紹介が主旨です。3つのサンプルシナリオを通して、シンプルなコマンドだけでコンテナの操作を一通り試せること、そしてマイクロサービスならではのサービス・ツール間の連携を、手元のサンドボックス環境で気軽に試せることを示せたのではないかと思います。
その中でも、発見として手応えがあったのがシナリオ3のKafkaの負荷試験です。「Kafkaは非同期でスケールする」ということ自体は知識として知っていても、実際に自分の手元でRESTとの差を数字で目の当たりにすると、体感としてそのパフォーマンスを実感できます。
今後は、セキュリティスキャンツールや、Agentgatewayのような MCP連携まわりのモジュールもNASEBANAL Quickstartsに加えて、より多くのデモ・テストシナリオを試せるようにしていきたいと考えています。そして、そこで得られるテスト結果を統合的に管理する仕組みを、NASEBANAL Evolutionの開発へとつなげていきたいと思っています。
自分の手元でも再現できるように、今回の3つのシナリオはいずれも NASEBANAL Quickstarts の README にそのまま載せています。興味があれば、make apps:upから触ってみてください。